05 · Validación honesta
Nivel 1 — El piso · Ruta de Aprendizaje
Si practicas con ejemplos y luego te evalúas sobre esos mismos ejemplos, es difícil separar comprensión de familiaridad. Con un modelo ocurre algo parecido. Validar es construir una pequeña representación de la situación futura: reservar ejemplos de modo que acertarlos requiera lo que queremos que el modelo aprenda, no una ventaja que desaparecerá al usarlo.
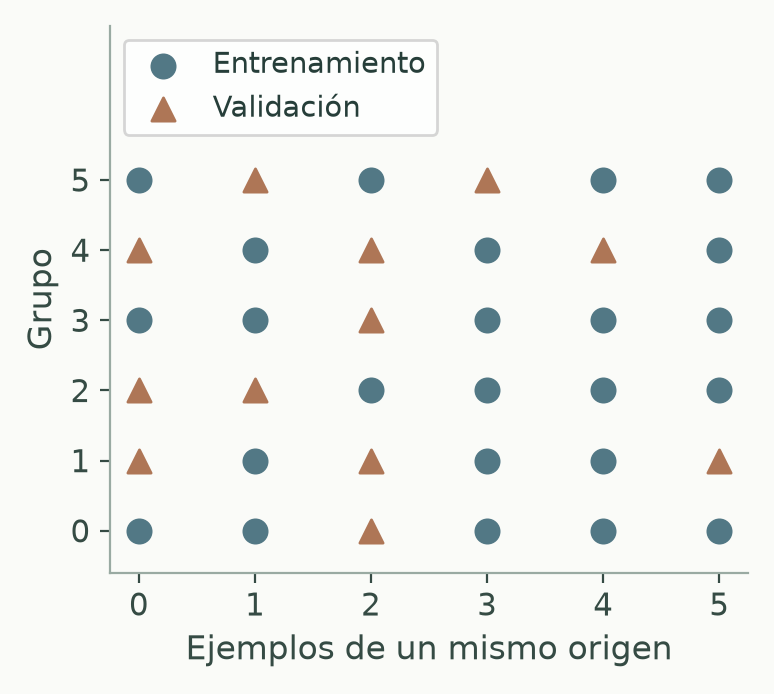
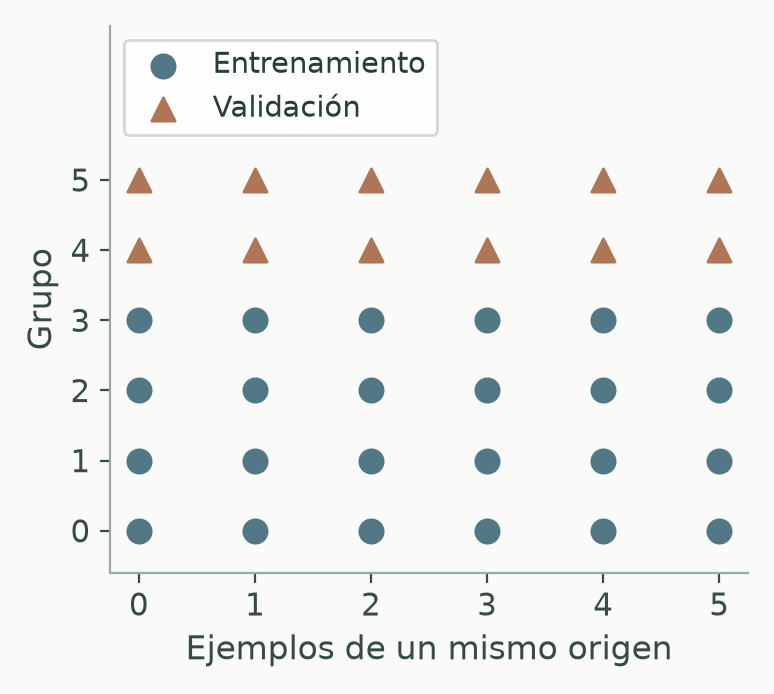
Azul: entrenamiento · naranja: validación. No son resultados de un modelo.
En el reparto aleatorio puede haber ejemplos del mismo origen a ambos lados. Esa validación observa orígenes ya conocidos. En el reparto por grupos se separan orígenes enteros: ahora se pregunta qué ocurre con uno nuevo. Ningún reparto es correcto por su apariencia; lo decide la pregunta de predicción.
Qué futuro queremos representar
Generalizar es aplicar una regla a ejemplos que no participaron en su ajuste. Pero «nuevo» admite varias posibilidades: otra lectura del mismo sensor, una lectura de un sensor desconocido o el mes siguiente de todos ellos. Esas situaciones no se simulan necesariamente con el mismo split.
En el formato individual 2026, el scoreboard A permite observar resultados durante el concurso y el B determina la clasificación final en otro split; Formato IOAI y estrategia describe el protocolo. Una validación local ayuda a experimentar, pero no garantiza un número idéntico al del evaluador: incluso muestras bien construidas pueden variar.
Un reparto aleatorio y lo que supone
Este ejemplo ejecutable crea datos sintéticos independientes, una fila por pieza. Los bloques de código del capítulo continúan con estos mismos datos:
import numpy as np

rng = np.random.default_rng(17)
X = rng.normal(size=(100, 2))
y = (X[:, 0] + 0.5 * X[:, 1] > 0).astype(int)
idx = rng.permutation(len(X))
train, val = idx[:80], idx[80:]
assert not set(train) & set(val)
print(len(train), len(val))  # 80, 20
El reparto aleatorio puede ser razonable si las filas representan unidades independientes de la situación que nos interesa. No necesita clases exactamente balanceadas, pero una clase muy escasa puede quedar sin ejemplos en validación. Tres circunstancias cambian cómo conviene separar:
| Situación | Idea del reparto | Qué evita o permite observar |
|---|---|---|
| Clases con proporciones distintas | Split estratificado: repartir dentro de cada clase | Reduce cambios accidentales del balance; con muy pocas filas por clase puede no alcanzar para representarlas a ambos lados |
| Nuevos orígenes, con varias filas por origen | Split por grupo: separar sensores, diálogos u otros grupos enteros | Evita medir reconocimiento de un origen conocido cuando interesa uno nuevo |
| Predicción del futuro | Corte temporal: pasado para ajustar, periodo posterior para validar | Evita usar información del futuro que no existiría al predecir |
La estratificación conserva aproximadamente proporciones, no crea información. Tampoco resuelve dependencias entre filas. Y un split temporal requiere ordenar bien los datos y respetar cuándo se calculó cada variable; separar fechas no repara una feature que ya contiene el resultado del mes siguiente.
Fuga: una ventaja que no existirá al predecir
Hay fuga de información cuando la preparación o el ajuste aprovechan algo que el protocolo pretendía mantener fuera de su alcance. Puede ser una respuesta reservada, una estadística del conjunto de evaluación o una variable calculada después del evento que querías anticipar.
| Situación problemática | Ejemplo | Reparación según el uso esperado |
|---|---|---|
| Aprender preprocesamiento con la evaluación incluida | Calcular medias con todo y después separar | Ajustar estadísticas en train y aplicarlas sin recalcular; Estandarizar sin fuga |
| Reconocer un origen que debía ser nuevo | Lecturas del mismo sensor en ambos conjuntos | Separar sensores completos |
| Seleccionar variables mirando respuestas reservadas | Elegir las más correlacionadas con y usando todas las filas | Repetir la selección solo dentro de cada entrenamiento |
| Dar información posterior al momento de predicción | Usar «reparación realizada» para anticipar la avería | Revisar procedencia y disponibilidad; excluirla si no existirá a tiempo |
Una correlación de 0.999 puede motivar una investigación, no demostrar una fuga. Una variable medida a tiempo podría ser muy informativa legítimamente. Y una variable con poca correlación individual podría revelar la respuesta al combinarse con otra. Hay que entender cómo se produjo la información.
Aprender un escalador con validación incluida tampoco garantiza que el score suba: puede subir, bajar o casi no moverse. El problema es que cambió la independencia del experimento. Algunos protocolos permiten aprovechar datos sin etiqueta de evaluación; esa es una condición explícita de la tarea, no algo que debamos suponer al evaluar generalización a ejemplos nuevos.
Una partición también tiene azar
En nuestro reparto hay veinte ejemplos de validación: una sola predicción
cambia accuracy en 1/20 = 0.05. Otra muestra podría dar un resultado distinto.
La validación cruzada repite el ajuste reservando distintas partes por
turnos, llamadas folds. Con cinco folds, cada entrenamiento usa cuatro partes
y se evalúa en la quinta; cada fila se evalúa una vez fuera de su ajuste.
from sklearn.model_selection import StratifiedKFold, cross_val_score
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression

modelo = make_pipeline(StandardScaler(), LogisticRegression(max_iter=1000))
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=17)
puntajes = cross_val_score(modelo, X, y, cv=cv, scoring="f1")
print("F1 de cada fold:", puntajes)
print("media:", puntajes.mean(), "desviación:", puntajes.std())
cross_val_score ajusta una copia de la propuesta en cada entrenamiento.
Al incluir el escalador dentro del pipeline, sus estadísticas también se
vuelven a aprender allí. Es posible hacerlo a mano, pero escalar todo una
sola vez antes de la validación cruzada usaría información de cada fold reservado.
La media resume esos resultados y la desviación muestra su variación. No es por sí sola un intervalo de confianza; los folds comparten gran parte de sus entrenamientos. Si una supuesta mejora es pequeña frente a la variación, conviene investigar antes de darla por estable.
Para grupos existe GroupKFold; para datos ordenados en el tiempo,
TimeSeriesSplit. El reparto debe seguir representando el uso futuro: repetir
cinco veces un split inadecuado no lo vuelve adecuado. Además son cinco ajustes,
por lo que bajo un presupuesto pequeño puede ser preferible una sola reserva
con suficiente información sobre los casos importantes.
También podemos adaptarnos demasiado a validación
Sobreajuste del modelo significa aprender particularidades del entrenamiento que no se sostienen en ejemplos nuevos. Una diferencia grande entre errores de train y validación puede ser una señal; no es la única explicación posible. Regularización, menos capacidad o Early stopping son alternativas que se estudian en los siguientes módulos.
Sobreajuste por selección puede ocurrir aunque cada fit respete el split.
Si comparas muchas variantes y eliges la de mayor score, también puedes elegir
la que tuvo más suerte en esa muestra. No hace falta memorizar sus respuestas
conscientemente. El mismo fenómeno puede aparecer con un leaderboard o con una
validación local consultada repetidamente.
Un test final reservado permite observar la propuesta después de fijar las decisiones. Si local y leaderboard discrepan, interesa revisar tamaño de muestra, orden de filas, grupos, disponibilidad de variables, distribución y selección previa. No corresponde creer automáticamente al número más alto ni al local.
Después de elegir una propuesta
Puedes conservar el modelo validado o volver a ajustarlo con todos los datos de desarrollo permitidos, manteniendo las decisiones ya elegidas. El segundo camino aprovecha más ejemplos, pero necesita seguir siendo estable y caber en el presupuesto; no promete una mejora automática.
Una vez que incorporas las antiguas filas de validación al entrenamiento,
su score deja de medir rendimiento fuera del ajuste. El test reservado
conserva esa función. La distinción es el papel de los datos en cada decisión,
no que un archivo se llame train.csv o test.csv.
Un experimento para mirar
En el cuaderno 04 · Validación por grupos de Laboratorios guiados, cada grupo tiene una firma casi repetida y una etiqueta aleatoria. Un vecino cercano puede reconocer firmas conocidas; no hay una regla que permita deducir la etiqueta aleatoria de un grupo nuevo. La figura hace visible qué pregunta responde cada score.
¿Cambiarías el reparto si la próxima fila perteneciera a un sensor conocido, a uno nuevo o al mes siguiente? ¿Cuántas unidades independientes aportan cien lecturas de un solo sensor? Repetir repartos por grupo permite observar variación sin buscar una semilla que produzca el número más favorable.
Ya tenemos una manera de comparar. Ahora podemos preguntar qué tipo de regla conviene proponer: una recta, vecinos, preguntas de un árbol u otra forma de frontera.
← 04 - Métricas · Ruta de Aprendizaje · 06 - Modelos clásicos →